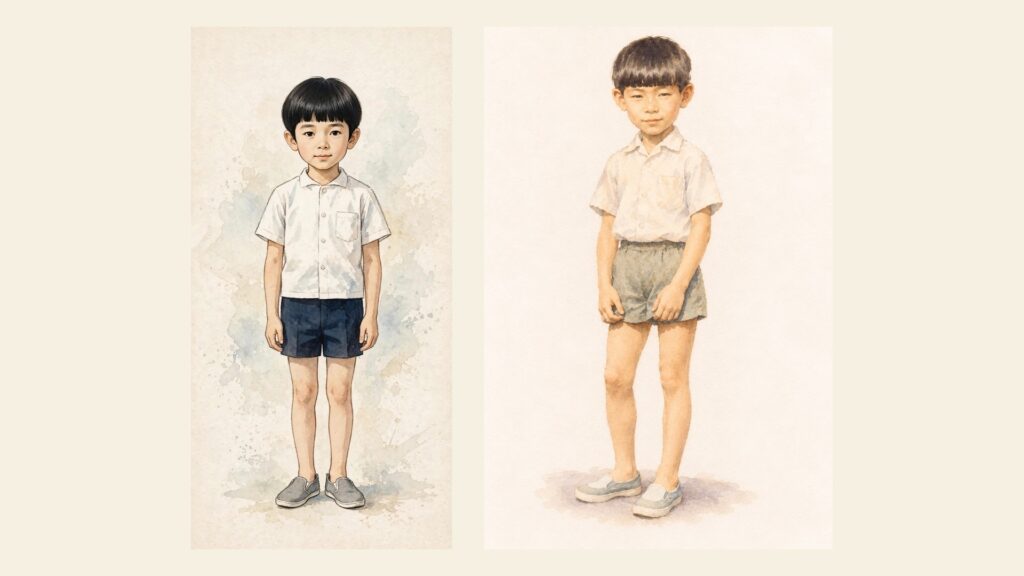
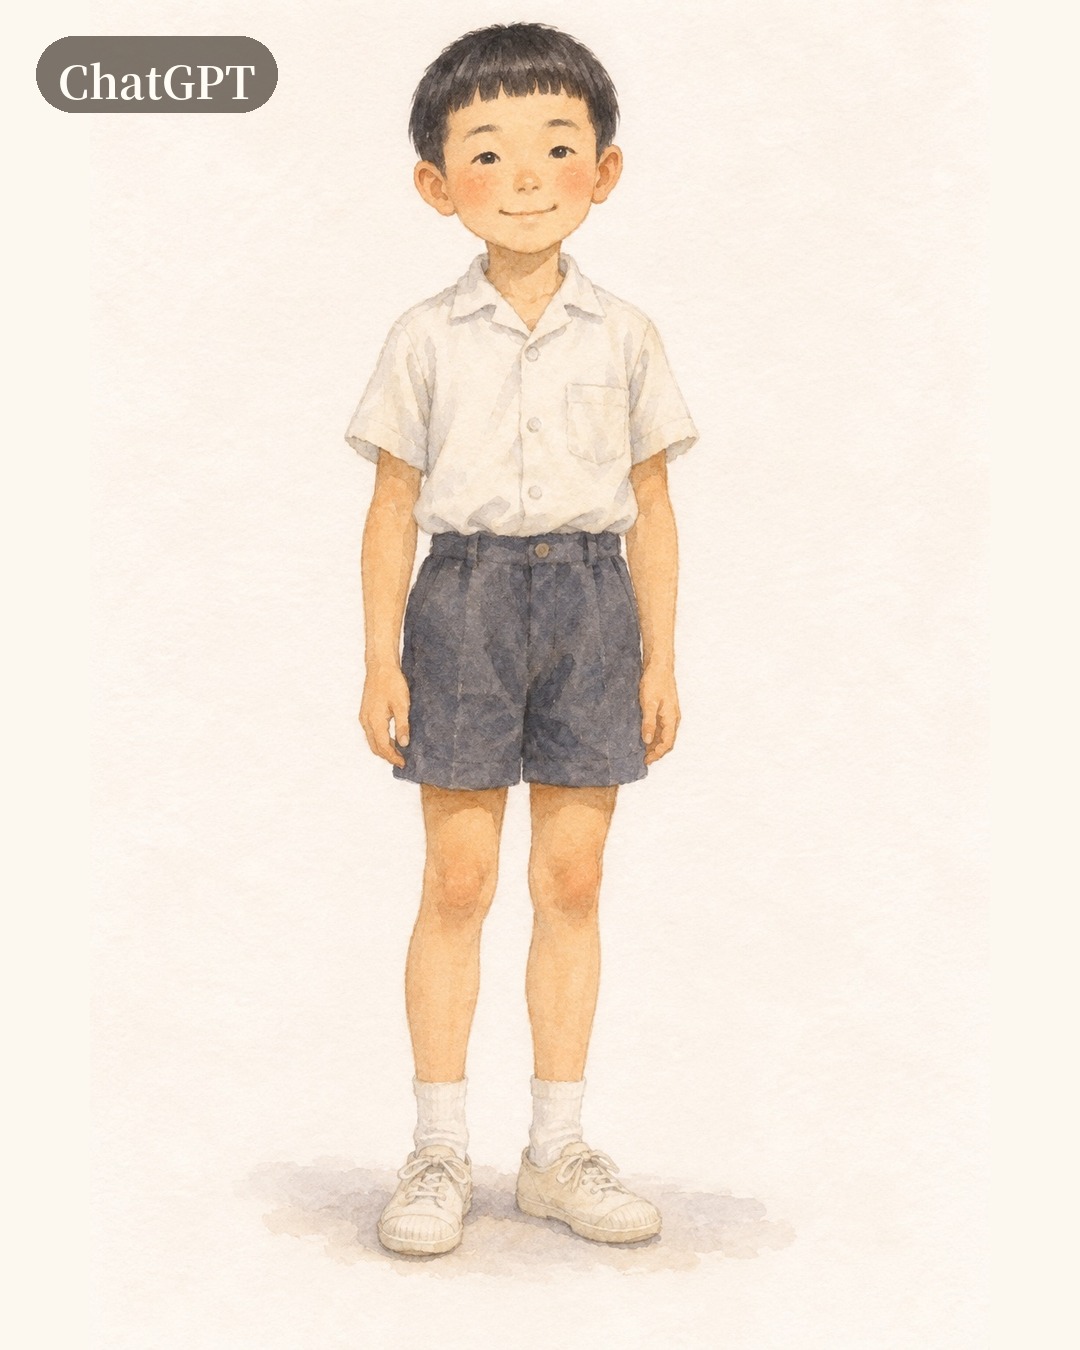
前回は、MuseとChatGPTに言葉だけのお題で描かせました。
プロンプトは下記です
1960年ごろの日本の8歳の男の子。
細身、短い黒髪、素朴な顔立ち。
坊ちゃん刈り、白い半袖シャツ、半ズボン、布のズック靴。
全身が見える立ち姿。
背景は白か薄い無地。
水彩絵本風で、やさしく懐かしい雰囲気。
できた絵は「昭和の少年」という一般的な像でした。
当然、懐かしい風ではあるけれど「誰の記憶でもない絵」なわけです。
今回は、自分の幼少時の写真を参考に渡してみました。
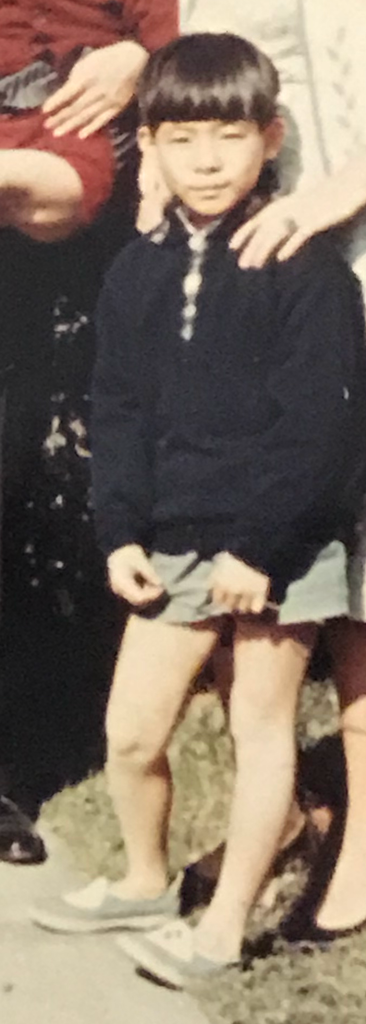
プロンプトはこうです。
画像のスタイルはこのまま保持して、顔立ち、髪型、体型、靴を写真に合わせて
比較のため、服は白い半袖シャツのままにした。
言葉だけの絵
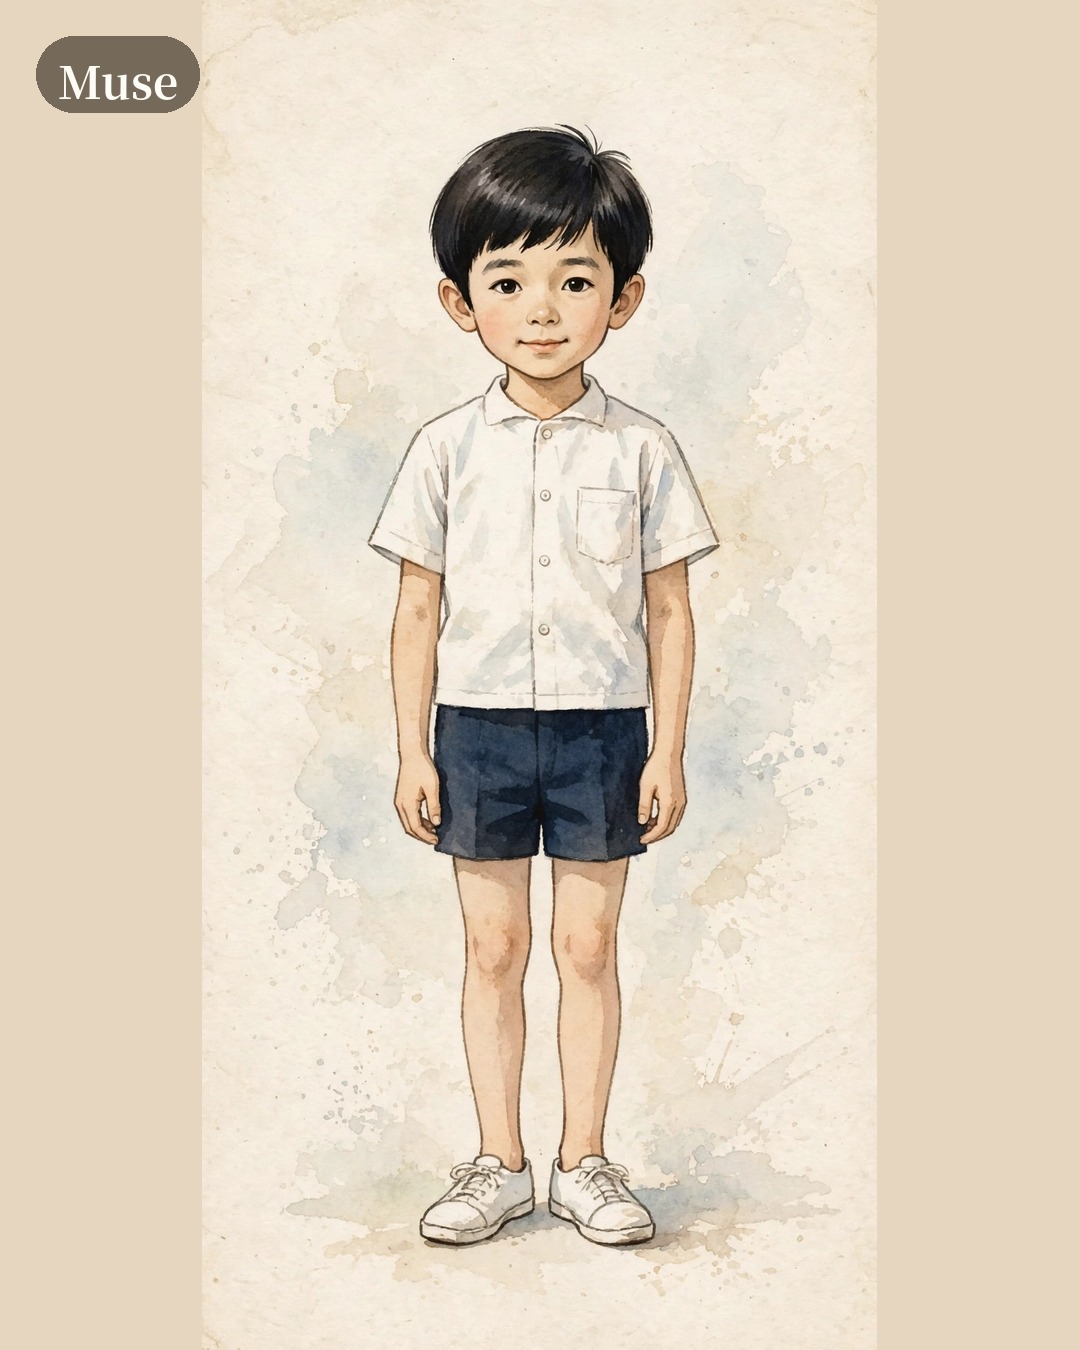
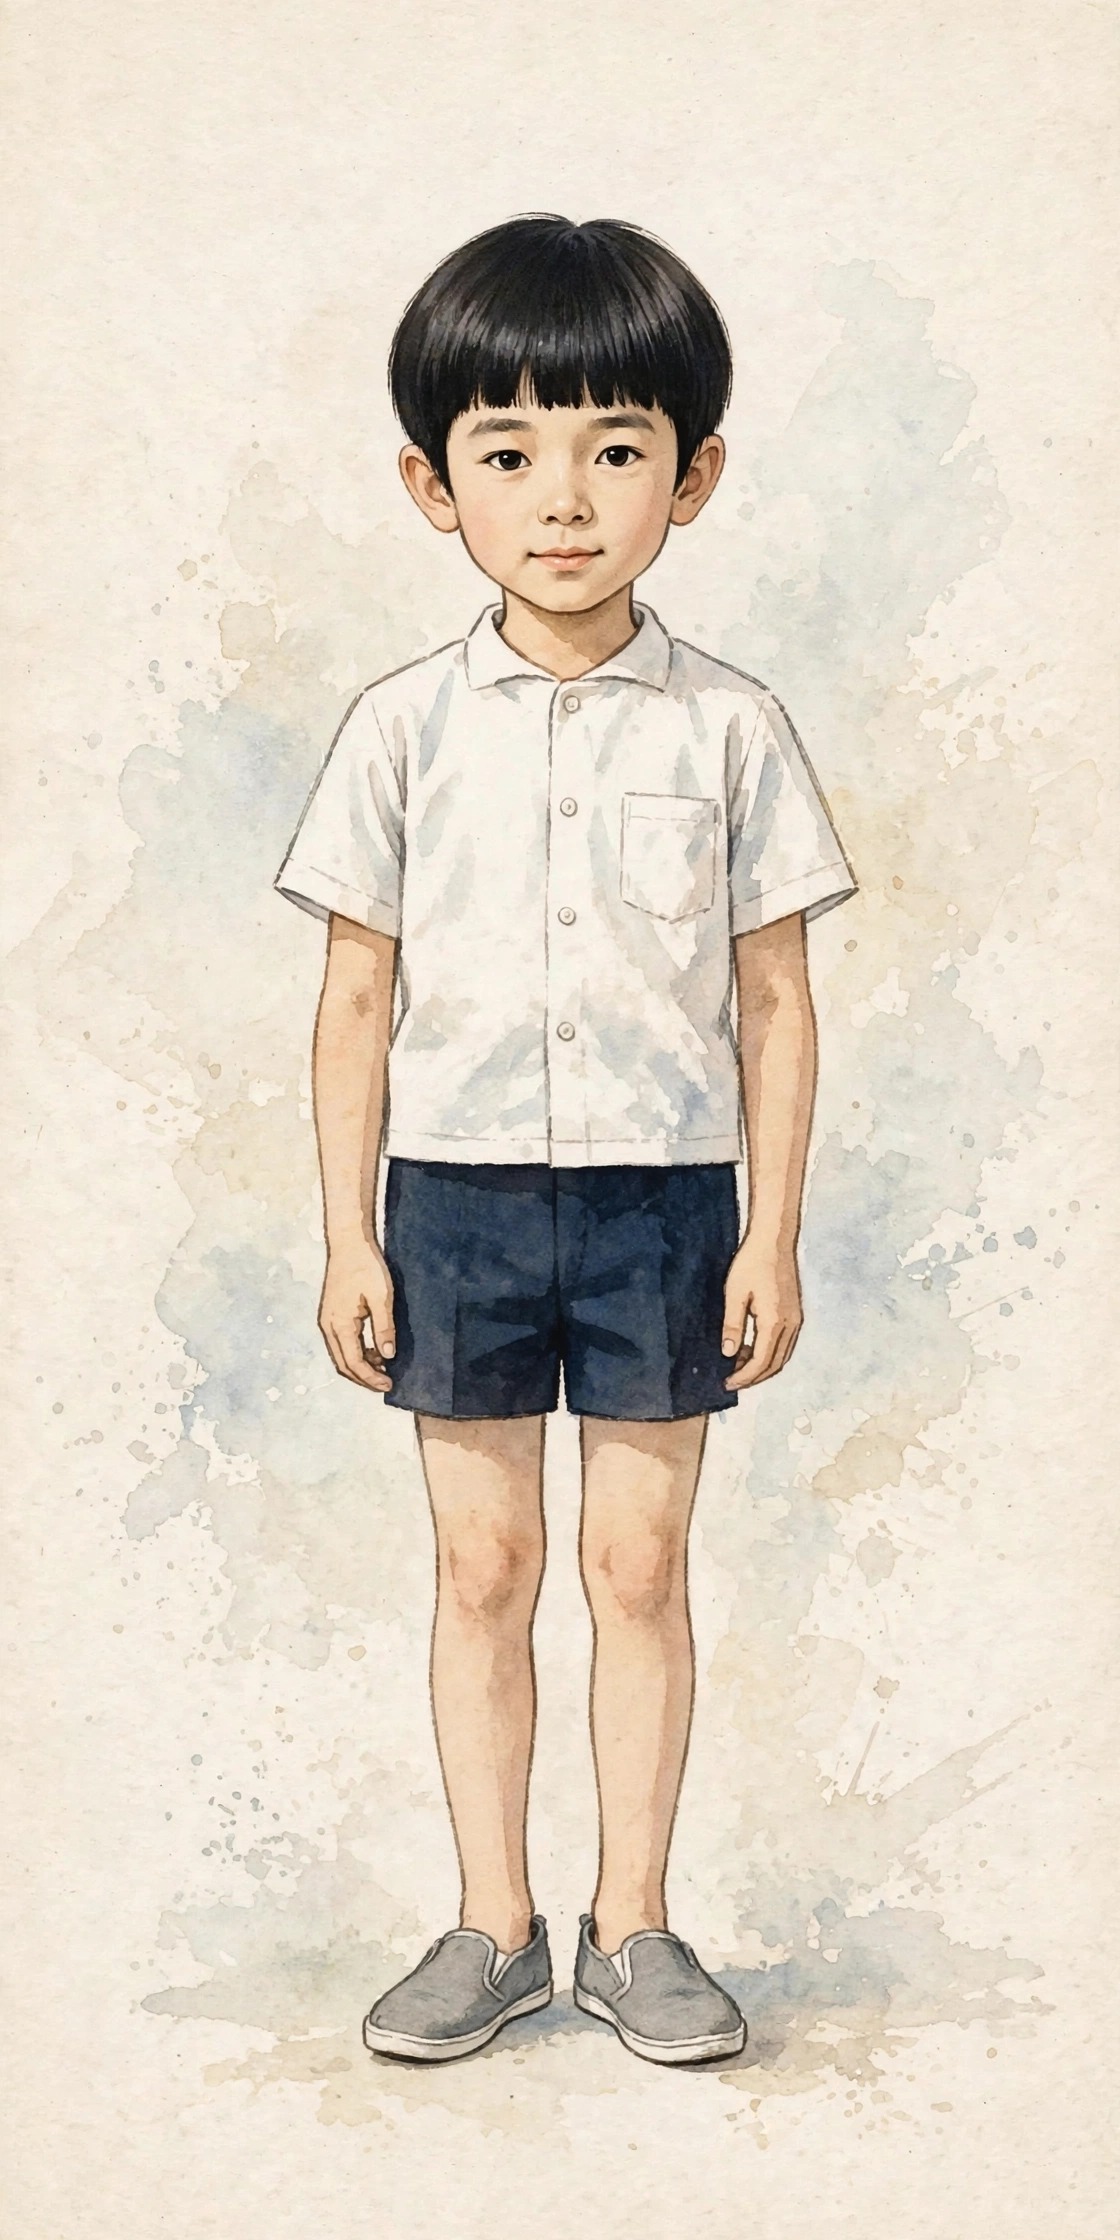
写真を参考にした絵
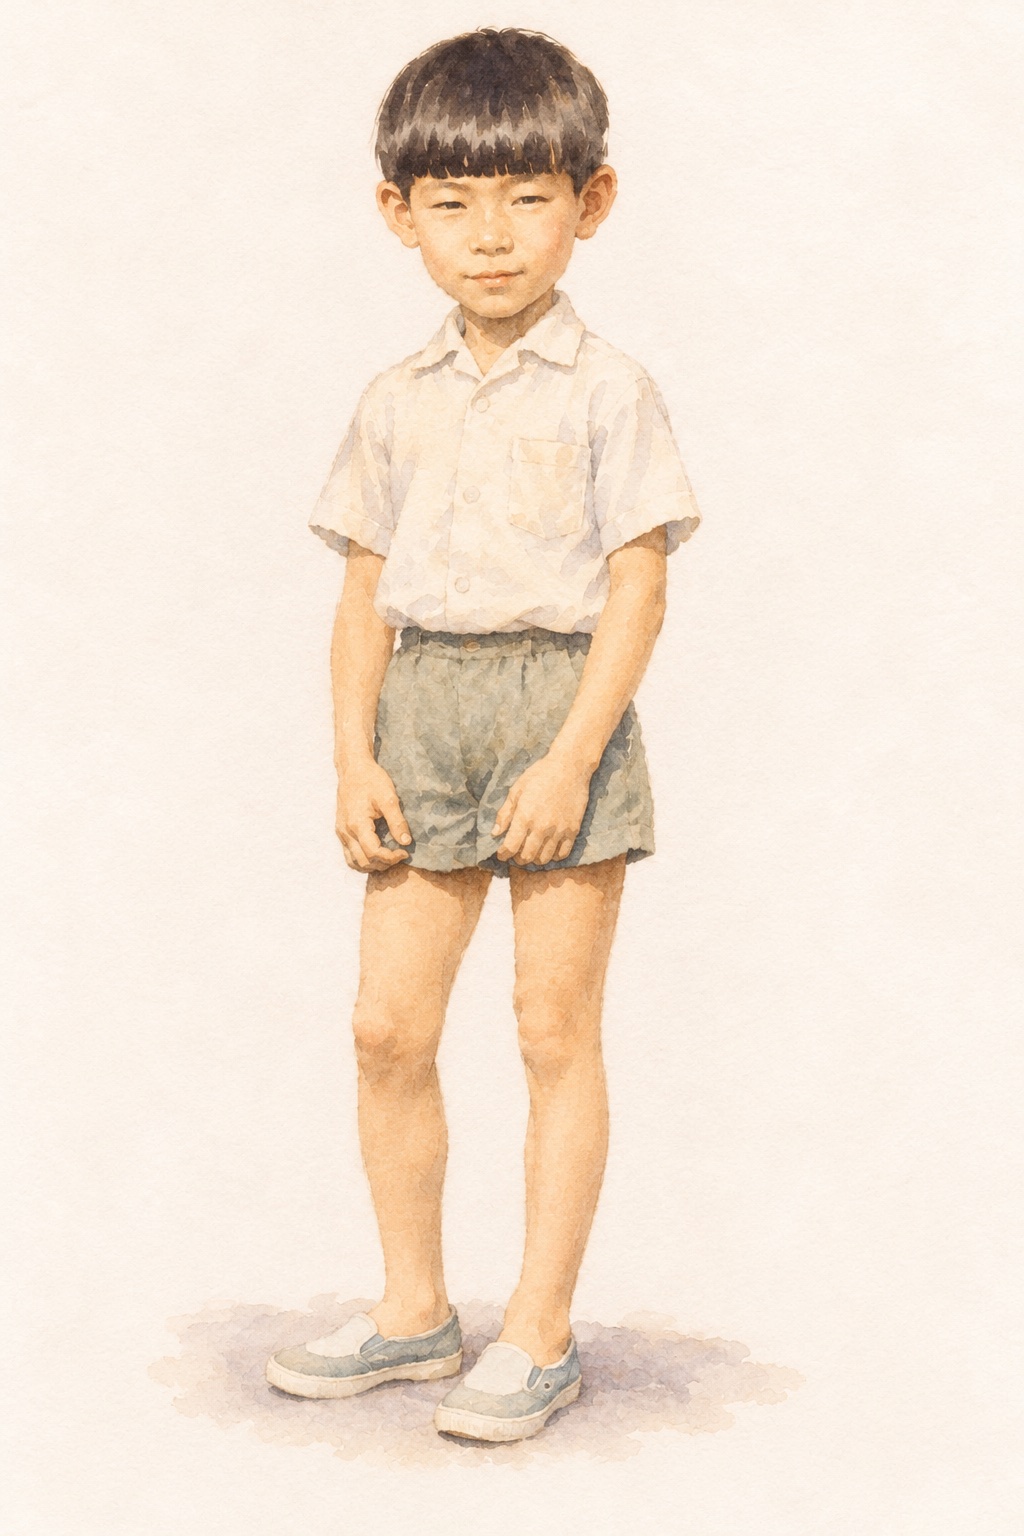
写真から入ってきたもの
ぱっつん前髪の坊ちゃん刈り。頭の大きめな体型。紐のないスリッポンの靴。
どれも、言葉では指定していなかった細部です。写真を渡すと、そういうものが絵に入ってきました。
2つのAIで、近づき方が違う
ChatGPTは、写真にかなり忠実でした。細めた目の感じ、耳の大きさ、靴の白とグレーの切り替え、半ズボンの丈まで写真寄りで、顔立ちも「こんな感じだったな」と思えます。
ただし、体型でいえば脚はもっと短いし、ポーズは写真に引っ張られてしまった。
Museは、写真の髪型や身につけている物の特徴は取り入れつつ、イラスト風に抽象化されている感じ。
指示(プロンプト)には忠実な印象だな。
同じ写真を渡しても、こんなふうに受け取り方が違う。スタイルに近いか、写真に近いか、という重み付けの違いです。
写真は手がかりになる
思い出はフラッシュバックのように浮かんで消えます。
細かいところがどうだったか、なかなか思い出せません。
その点写真は事実を見せてくれるので、
「ああそうだったな」と納得できます。
写真を手がかりに渡すと、AIの絵は一般的な像から、自分の記憶に近づきました。
写真のない場面も、こうして描けるかもしれません。
前回の記事:「昭和の少年を2つのAIに描かせてみた」